차·차·차 만들기 2: 자료 11종을 표 18개로
빠진 자료를 0으로 읽지 않으려고 표를 나눈 이야기
목차 9펼치기접기
자료 11종을 한 화면에 나란히 놓으면 모두 같은 날의 숫자처럼 보입니다. 하지만 등록 대수는 2026년 9월 자료이고, 구 경계는 2013년 자료입니다.


이 자료들이 MySQL 표 18개, 외래키 25개, 111,676행이 됐습니다. 정규화는 팀장이자 PM인 제 몫이었고, 전체 ERD 설계와 MySQL 적재는 다른 팀원 한 명이 맡았습니다. 자료를 모으고 다듬는 일은 데이터 팀원과 크롤링 팀원이 나눠 했습니다.
자료마다 '언제'가 달랐습니다
기준 시점을 자료별로 모으면 이렇습니다.
| 자료 | 기준 시점 |
|---|---|
| 국토교통부 자동차 등록 | 2026년 9월 |
| 서울시 연료별 자동차 등록 | 2026년 9월 |
| 주민등록 인구·세대 | 2026년 9월 |
| 서울 TOPIS 교통량 | 2026년 9월 한 달 |
| 서울 행정동별 대중교통 승객 | 10월 30~31일 |
| 기상청 날씨 | 10월 30~31일 48시간 |
| 전국주차장정보표준데이터 | 행마다 다름 |
| 한국환경공단 충전소 | 받은 순간의 값 |
| 서울시 공공 충전소 | 미상 |
| 현대자동차 EV FAQ | 미상 |
| 통계청 서울 구 경계 | 2013년 |
판정에는 이틀 치 승객 자료 가운데 10월 30일 하루만 씁니다. 출처를 적는 표에는 자료가 설명하는 기간, 제공 페이지가 바뀐 날, 저희가 받은 날을 서로 다른 열로 나눠 담았습니다. 기준일을 모르면 미상으로 두고, 받은 날을 기준일처럼 쓰지 않았습니다.
모으면서 걸린 것
서울시 공공 충전소 자료로는 지도를 그릴 수 없었습니다. X 좌표가 94만에서 97만 사이라 경위도가 아니었고, 서울 행도 429개뿐이었습니다.
그래서 기본 출처를 한국환경공단 충전소 API로 바꿔, 서울 충전기 75,607기를 썼습니다. 다른 자료도 손볼 곳이 있었습니다.
- 국토교통부 등록 현황은 CSV로 받으면 천 단위 콤마 때문에 숫자가 깨질 수 있어서, xlsx를 시트째 읽었습니다. 주민등록 CSV는 cp949로 열었습니다.
- 현대 일반 FAQ는 동적 페이지라 받은 HTML에 답변이 없었습니다. 정적인 EV 에브리케어 FAQ 10문항을 BeautifulSoup으로 파싱해 DB에 넣었습니다.
- 서울 행정동별 등록 자료를 더하면 국토교통부 합계보다 3,284대 모자랐습니다. 원인을 찾지 못해 합계가 맞는 구별 자료만 썼습니다.
- 주차장 857행 중 22행은 관리번호가 겹쳤습니다. 지우지 않고 남기되 면수 합산과 지도에서는 뺐습니다.
같은 EV FAQ 페이지를 Selenium으로 직접 열어 모으는 수집기는 데이터 팀원이 만들었습니다. 이쪽 결과는 DB에 넣지 않고 검토용 CSV로만 남깁니다.
raw ERD에서 2NF로
raw ERD부터 그렸습니다. 처음 고른 원본 파일 13개를 모양 그대로 옮긴 표 13개입니다.
승객 원본은 시간대마다 수단별 승객을 옆으로 펼쳐 둔 탓에 열이 280개를 넘었습니다. 이걸 세로로 돌려 구별로 합치는 건 정제일 뿐, 정규화는 아니라고 저는 선을 그었습니다.
복합키의 일부에만 달린 정보를 떼어 내는 일이 2NF입니다. 설명용 가상 예시로 보면 이렇습니다.
| 충전소+기기 | 충전소 주소 | kW |
|---|---|---|
| 101+01 | 가 주소 | 100 |
| 101+02 | 가 주소 | 7 |
| 102+01 | 나 주소 | 50 |
이 표에서 주소는 기기 번호 없이 충전소 번호만으로 정해집니다. 이대로 두면 주소를 여러 행에서 고쳐야 하고, 마지막 기기를 지우면 충전소 정보까지 사라집니다. 그래서 주소는 charging_station, 기기별 출력은 charger에 두었습니다. 실제 환경공단 자료는 충전소 13,098행과 충전기 75,607행으로 갈렸습니다.
등록 표에서도 구 이름과 차종 이름은 region, vehicle_type으로, 구와 월로 정해지는 인구·세대는 region_context로 뺐습니다. 그렇게 나눈 결과가 지금의 2NF ERD입니다.
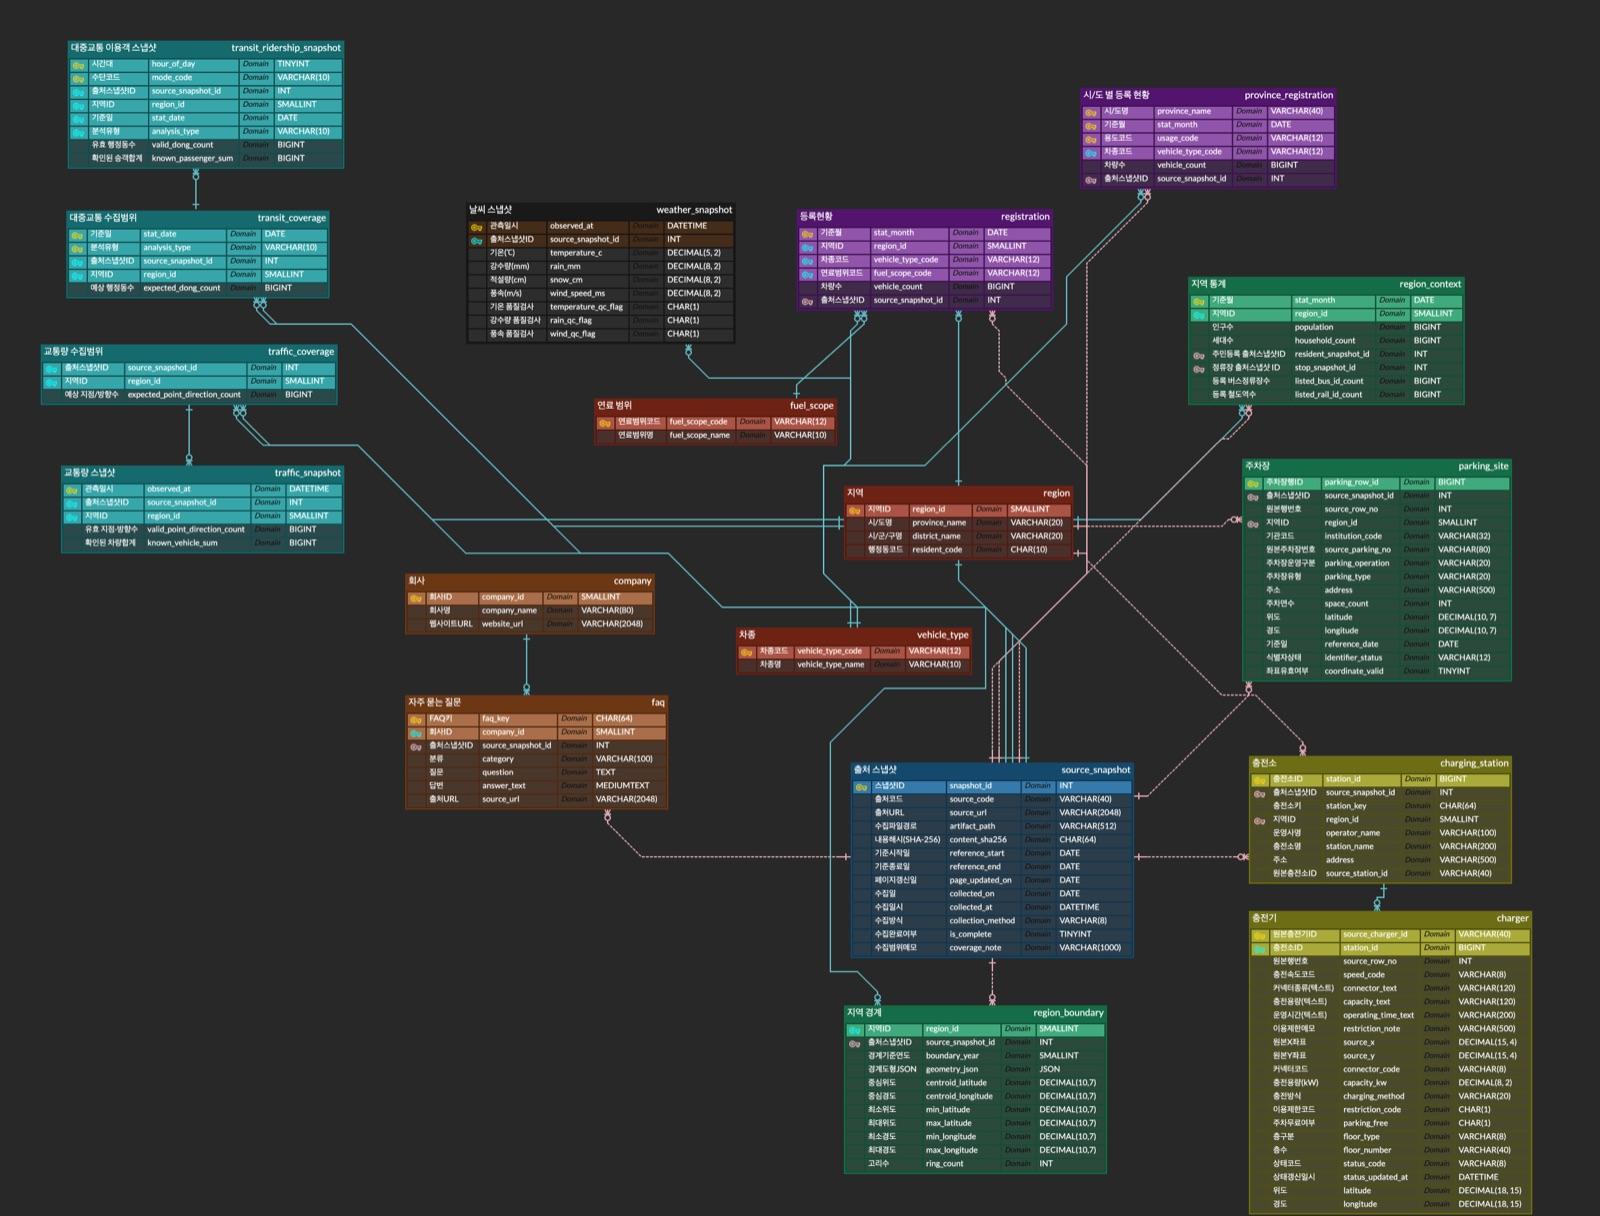
가운데 아래 파란 표가 출처를 적는 source_snapshot이고, 여러 표에서 나온 점선 관계선이 이 표로 모입니다. 색은 묶음을 뜻합니다.
| 색 | 묶음 |
|---|---|
| 빨강 | 기준 코드 3개 |
| 파랑 | 수집 기록 1개 |
| 보라 | 차량 등록 2개 |
| 노랑 | 충전 2개 |
| 주황 | 기업 FAQ 2개 |
| 초록 | 지역 3개 |
| 청록 | 교통·승객 4개 |
| 검정 | 날씨 1개 |
핵심 표 12개에 교통·승객·날씨 시간자료 5개가 더해지고, 지도용 구 경계가 마지막에 들어와 18개가 됐습니다. 범위를 잡을 때 그린 마인드맵의 주차장 가지에는 요금·운영·감면도 있었습니다. 표 세 개로 설계까지 했지만, 자료 범위를 정하지 못해 스키마에 주석으로만 남았습니다.
한 행은 무엇인가
같은 구, 같은 달에도 차종이 4개, 범위(전체·전기)가 2개입니다. 구와 월만으로는 한 행이 정해지지 않아, 구·월·차종·연료 범위 네 칸을 묶어 기본키로 삼았습니다.
PRIMARY KEY (
  region_id, stat_month,
  vehicle_type_code, fuel_scope_code
)
표 18개 중 10개가 이렇게 복합키를 기본키로 씁니다. 주차장은 관리번호가 겹치는 22행 때문에 원본 번호 대신 내부 번호를 기본키로 두고, 수집본과 원본 행 번호 조합에 UNIQUE를 걸었습니다. 충전기 원본 번호는 앞자리 0을 지키려고 문자열로 저장했습니다.
0이 아니라 NULL
11월 6일, 저는 교통량과 승객, 날씨 같은 시간자료를 앱에서 그때그때 부르지 않기로 정했습니다. 기간을 정해 한 번 받아 MySQL에 넣고, 화면은 조회만 합니다.
그런데 받아 둔 자료에는 빈 곳이 있습니다. 값이 작게 나왔을 때 정말 작은 건지, 일부만 관측돼서 작은 건지 가려야 했습니다. 그래서 교통과 승객은 표를 둘로 나눴습니다.
coverage 쪽에는 있어야 할 관측 범위를 둡니다. 교통은 관측 지점·방향 수, 승객은 행정동 수입니다. snapshot 쪽에는 그 시각에 실제로 확인된 값과 그 개수를 둡니다. 관측이 하나도 없으면 0이 아니라 NULL이 되도록 CHECK도 걸었습니다.
CHECK (
  (valid_dong_count = 0
    AND known_passenger_sum IS NULL)
  OR (valid_dong_count > 0
    AND known_passenger_sum IS NOT NULL)
)
덕분에 빠진 자료를 셀 수 있습니다.
승객 3,600행 중 일부 동이 빠진 행은 1,296개입니다. 교통은 강북구에 연결된 관측 지점이 하나도 없어서, 시간별 교통량 17,280행에 강북구가 없습니다.
첫 화면인 우리 동네의 서울 자동차 현황도 같은 원칙을 따릅니다. 25개 구 중 한 곳이라도 값이 비면, 빈 값을 0으로 채워 더하지 않고 '자료 없음'으로 보여 줍니다. 이 부분은 데이터 팀원이 넣었습니다.
출처를 적는 표, source_snapshot
source_snapshot은 자료 한 종에 한 행씩, 모두 11행입니다. 행마다 출처 코드, 원문 주소, 원본 해시와 함께 앞에서 말한 기간·갱신일·수집일을 담습니다.
등록·주차·충전·FAQ 같은 표가 이 표를 외래키로 가리킵니다. 같은 수집본이 두 번 들어오지 못하게, 출처 코드와 해시 조합에는 UNIQUE를 걸었습니다. 외래키와 출처별 건수, 결측 검사를 모두 통과한 수집본에만 is_complete=1이 붙고, 앱의 조회는 이 표시가 붙은 수집본만 씁니다. 자료 안내 화면의 출처 표와 기업 FAQ의 수집일도 여기서 나옵니다.
저는 DB 덤프와 정제 CSV, 원본 데이터, 기업 FAQ 원문을 공개 저장소에 올리지 않기로 했습니다. 기업 FAQ 원문은 재배포할 수 없고, 일부 공공데이터는 이용 조건을 확인하지 못해서였습니다. 저장소에는 데이터 대신 코드와 출처 문서를 두고, 덤프는 팀 안에서만 나눴습니다.
판정 SQL: 동률과 빈 값
1편에 세 판정의 기준을 표로 두었습니다. 여기서는 순위를 매기는 SQL만 열 이름을 줄여 옮깁니다.
CASE
  WHEN vehicle_per_household
       IS NOT NULL
  THEN RANK() OVER (
    ORDER BY vehicle_per_household DESC
  )
END AS ownership_rank
그 순위로 라벨을 붙입니다.
CASE
  WHEN vehicle_per_household IS NULL
    THEN '자료 없음'
  WHEN ownership_rank <= 8 THEN '많은 편'
  WHEN ownership_rank <= 17 THEN '보통'
  ELSE '적은 편'
END AS ownership_level
지표가 NULL이면 순위도 NULL이고, 라벨은 '자료 없음'입니다. 동률이면 같은 순위를 주고 다음 순위는 건너뛰어서, 묶음마다 구 수가 달라질 수 있습니다. 지금은 세 판정 모두 8개, 9개, 8개 구입니다.
조회할 때 SQL이 판정 순위를 계산합니다. 두 동네 비교 화면도 25개 구 전체 순위를 먼저 매긴 뒤 두 구를 고릅니다. 그래서 두 구만 놓고 봐도 서울 안의 순위가 그대로 보입니다.
ERDCloud와 DBeaver
ERD는 ERDCloud에 그렸습니다. 팀 공간에 팀원들을 초대해 같이 고쳐 가며 썼습니다.
스키마 SQL을 그대로 가져오는 방식이었는데, 처음에는 관계선이 절반 가까이 빠졌습니다. ALTER TABLE로 더한 외래키는 선이 되지 않았고, 따로 가져온 표 사이에도 선이 생기지 않았습니다.
그러다 관계선과 키 컬럼이 통째로 지워진 ERD를 발견했습니다. 원인은 확인하지 못했습니다. 표를 모두 지우고, 외래키를 CREATE TABLE 안에 넣은 SQL을 한 번에 다시 가져왔습니다. 그제야 선이 모두 그려졌습니다.
팀원들이 붙여 둔 한글 이름도 다시 입혔고, 복구용 파일은 따로 보관했습니다. 지금 schema.sql은 외래키를 모두 CREATE TABLE 안에 둡니다. ERDCloud로 가져올 구간과 MySQL에서만 거는 CHECK 구간도 주석으로 나눠 뒀습니다.
대표 SQL 7개는 DBeaver에서 한 문장씩 실행해 볼 수 있게 문서로 정리했습니다. 로컬 DB를 클라우드 MySQL(DBaaS)로 옮긴 이야기는 3편에 있습니다.
아직 남은 것
알고 있는 한계도 있습니다.
- 주차 면수에는 표준데이터에 실린 주차장만 들어갑니다. 아파트 주차장과 빈자리 정보는 없습니다.
- 승객 자료에서 강서구의 일부 행정동이 빠졌습니다. 판정은 나오지만 실제보다 작게 집계될 수 있어 화면에 안내를 붙였습니다.
- 등록 자료가 2026년 9월 한 달뿐이라 월별 추이는 보여 줄 수 없습니다.
charger에는 위도와 경도, 운영시간, 주차 무료 여부가 기기마다 들어 있습니다. 충전소 쪽으로 뗄 수도 있는 값이지만 원본이 충전기 단위로 와서 그대로 뒀고, 지도에는 충전소마다 기기 한 대의 좌표를 골라 씁니다.
빈 값을 0으로 채우지 않았으므로, 화면에서 모르는 값을 '자료 없음'으로 표시할 수 있습니다. 다음 편은 이 DB 위에 화면과 카카오 지도를 얹은 3편입니다. 코드는 코드 저장소에, 서비스는 배포 사이트에 있습니다.