요약
이 포트폴리오의 프로젝트는 대부분 Claude Code와 페어로 만들었습니다. AI 에이전트와 오래 일하다 보면 같은 실수가 반복되는데, 그때마다 "다음엔 하지 마"라고 적어 두는 것만으로는 막히지 않았습니다. 그래서 실수를 규칙이 아니라 장치로 막는 환경을 만들었습니다.
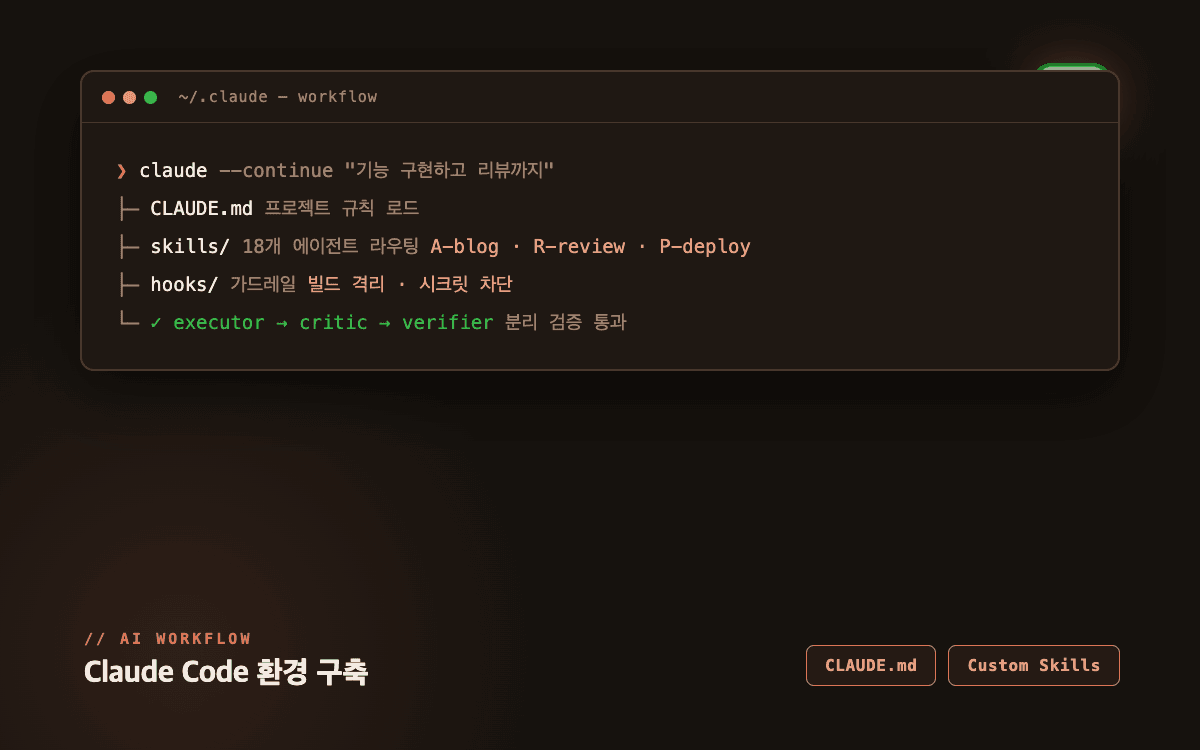
이 프로젝트는 하나의 앱이 아니라 일하는 방식입니다. 훅 가드, 프로젝트별 스킬, 작성과 검증을 나눈 리뷰 구조로 이뤄져 있고, 이 사이트와 ExamAI, 채집 마스터에 실제로 적용돼 있습니다.
| 항목 | 내용 |
|---|---|
| 훅 가드 | PreToolUse 가드 4종 (ExamAI 저장소), 커밋 검증 가드는 Vitest 테스트 23개 |
| 프로젝트 스킬 | 이 사이트 18개 이상, ExamAI 11개, 채집 마스터 6개 |
| 리뷰 구조 | 작성 · 검증 · 비평을 다른 에이전트로 분리 |
| 공개 문서 | 입문 가이드, 스킬 시스템, 멀티 에이전트 재구축 글 3편 |
적어 둔 규칙은 잊힌다
"dev 서버가 켜져 있을 때 빌드하지 말 것" 같은 규칙을 메모리와 CLAUDE.md에 적어 두어도 같은 실수가 다시 나왔습니다. dev 서버 중에 빌드를 돌리면 .next가 깨져 5~10분을 날리고, 프로세스를 이름으로 일괄 종료하면 다른 프로젝트의 서버까지 죽습니다.
| 단계 | 내용 |
|---|---|
| 결정 | 도구가 실행되기 직전에 검사하는 PreToolUse 훅으로 옮겼습니다 |
| 가드 4종 | 프로세스 일괄 종료 차단, dev 서버 실행 중 빌드 차단, 금지 문장 부호 필터, 커밋 전 검증 결과 확인 |
| 트레이드오프 | 커밋 검증 가드는 에이전트가 실행한 명령만 볼 수 있어서, 기본값을 "경고"로 두고 단계적으로 도입했습니다. 차단 모드는 충분히 검증된 뒤에 켜는 선택지로 남겼습니다 |
| 검증 | 가드 1~3은 도입할 때 11개 케이스로 직접 확인했고, 커밋 검증 가드는 임시 git 저장소를 쓰는 Vitest 테스트 23개로 검증합니다 |
작업마다 다른 규칙: 스킬
이 사이트에서 "블로그 글 써줘"와 "보안 뉴스 써줘"는 서로 다른 규칙으로 동작합니다. 작업 유형마다 스킬 파일이 체크리스트를 들고 있기 때문입니다. 글쓰기 톤 가이드도 스킬로 분리해서, AI 특유의 과장 어휘와 상투적인 전환구를 금지어로 관리합니다.
최근에 만든 스킬은 디자인 측정 도구 design-qa입니다. 표가 잘리는지, 목차 링크가 실제 제목과 맞는지, 글자 대비가 충분한지, 차트 색이 서로 겹치지 않는지를 실제 브라우저로 잽니다. 빌드와 타입 검사로는 잡히지 않는 문제들이라 따로 만들었습니다.
자기 작업을 자기가 승인하지 않는다
혼자 만든 결과물을 같은 에이전트에게 평가시키면 대부분 "좋다"는 답이 돌아옵니다. ExamAI 토스 미니앱 작업에서 역할을 셋으로 나눴습니다.
- 메인이 방향을 정하고, 워커가 구현합니다
- 사용자 관점의 비평 에이전트는 구현 맥락 대신 결과물과 이전 판정만 보고 반박합니다
8번의 라운드에서 비평 에이전트가 방향을 바꾼 지점이 4번 나왔습니다. 체감이 거의 없는 작업을 건너뛰게 하거나, 과한 설계를 경고한 경우입니다. 이 사이트의 PR도 같은 원칙으로, 구현과 독립 리뷰를 다른 에이전트가 맡습니다. 최근 포트폴리오 개편에서도 리뷰가 "자동 발행 글 292편"이라는 과장된 숫자를 잡아냈습니다.
기억도 관리 대상이다
에이전트용 메모리 파일은 쌓이기만 하면 독이 됩니다. 채집 마스터의 메모리가 60KB까지 불어나 옛 디자인과 현재 디자인이 섞였습니다. 현재 판단이 흐려지는 게 보여서, 메모리는 짧은 포인터만 남기고 현재 상태의 정본은 저장소의 CLAUDE.md로 옮겼습니다. 옛 기록은 "근거로 쓰지 말 것"을 붙여 따로 보관합니다.
배운 점
AI 코딩의 생산성은 모델보다 환경 설계에서 갈렸습니다. 같은 모델이라도 가드와 검증 구조가 있는 프로젝트에서는 결과가 안정적이었고, 없는 프로젝트에서는 매번 품질이 출렁였습니다. 도구를 잘 쓰는 법의 절반은 도구가 실수하기 어려운 환경을 만드는 일이었습니다.