파이썬 공부 Day 6: 정규 표현식 · 워드클라우드 · 클래스패턴으로 찾고, 많이 쓴 단어를 그리고, 설계도로 객체를 찍어 냈습니다
Day 6에는 세 가지를 공부했습니다. 문자열에서 패턴을 찾는 정규 표현식, 글에서 많이 나온 단어를 크게 그리는 워드클라우드, 데이터와 함수를 한 묶음으로 만드는 클래스입니다. 끝에는 주사위 문제를 풀다가 제 코드가 우연히 맞고 있던 부분을 찾은 이야기를 적었습니다.
Day 5에서 배운 with 문과 파일 읽기는 워드클라우드에서 그대로 다시 씁니다. 정규 표현식도 워드클라우드 전처리에서 한 번 더 나옵니다.
🔍 정규 표현식: 반복문 열 줄을 한 줄로
이름과 전화번호가 섞인 문자열에서 번호 뒤 4자리를 XXXX로 가리는 문제였습니다. 처음엔 공백으로 쪼갠 뒤 길이와 숫자 자리를 하나하나 검사했습니다.
peoples = ('영수: 010-1234-5678 '
           '영철: 010-4321-8765 '
           '옥순: 010-2143-6587')

phone_x = []
for word in peoples.split(' '):
    if (len(word) == 13
            and word[:3].isdigit()
            and word[4:8].isdigit()
            and word[9:].isdigit()):
        word = word[:8] + '-XXXX'
    phone_x.append(word)
print(' '.join(phone_x))
# 출력(실제로는 한 줄)
# 영수: 010-1234-XXXX 영철: 010-4321-XXXX
# 옥순: 010-2143-XXXX
정규 표현식은 이런 패턴을 적는 공통 문법입니다. 파이썬 전용이 아니고, 파이썬에서는 re 모듈로 씁니다. 위 반복문이 re.sub(패턴, 바꿀 값, 문자열) 한 줄이 됩니다.
import re

# 010-1234는 ( )로 묶어 두고 뒤 4자리는 버림
print(re.sub(r'(\d{3}-\d{4})-\d{4}',
             r'\g<1>-XXXX', peoples))
# 결과는 반복문 버전과 같음
| 조각 | 뜻 |
|---|---|
\d | 숫자 한 글자 |
{3} | 바로 앞 것을 정확히 3번 |
( ) | 그룹. 맞은 부분을 기억 |
\g<1> | 1번 그룹을 다시 꺼내 씀 |
r'...' | \를 그대로 두는 raw string |
r을 빼면 파이썬이 '\d'를 문자열 이스케이프로 먼저 읽으려 해서, 3.12부터는 SyntaxWarning이 뜹니다. 정규식은 항상 r'...'로 쓰기로 했습니다.
같은 패턴을 여러 번 쓸 거면 re.compile()로 미리 만들어 둡니다. C(POSIX)에서 regcomp()로 컴파일하고 regexec()로 실행하던 2단계와 같은 구조입니다. 파이썬은 re.sub()처럼 바로 써도 안에서 컴파일하고 캐시해 둡니다.
pat = re.compile(r'(\d{3}-\d{4})-\d{4}')
print(pat.findall(peoples))
# ['010-1234', '010-4321', '010-2143']
findall()은 패턴에 그룹이 있으면 그룹 부분만 돌려줍니다. 번호 전체가 아니라 앞 8자리만 나온 이유입니다.
주민번호 뒷자리도 같은 방법으로 가렸습니다. 바꿀 값 안의 *는 패턴 기호가 아니라 그냥 글자입니다.
ids = ('영수: 800104-1049234 '
       '영자: 760405-1052114')
print(re.sub(r'(\d{6})-\d{7}',
             r'\g<1>-*******', ids))
# 영수: 800104-******* 영자: 760405-*******
match · search · findall
| 함수 | 찾는 범위 | 결과 |
|---|---|---|
re.match | 맨 앞에서만 | Match 또는 None |
re.search | 어디서든 첫 하나 | Match 또는 None |
re.findall | 전부 | 리스트 |
string = 'I have a Dream.'

print(re.match('a', string))  # None
print(re.search('a', string))
# <re.Match object; span=(3, 4), match='a'>
print(re.findall('a', string))
# ['a', 'a', 'a']
이름만 보면 match가 찾아 줄 것 같지만, 맨 앞이 I라서 None입니다. 문자열 중간에서 찾으려면 search를 씁니다. 결과로 받은 Match 객체에서는 맞은 글자와 위치를 꺼냅니다.
result = re.search('ha', string)
if result:  # 못 찾으면 None이라 거짓
    print(result.group())  # ha
    print(result.span())  # (2, 4)
span()의 끝 값 4는 마지막 글자의 다음 칸입니다. 슬라이싱과 같은 규칙이라 string[2:4]로 자르면 그대로 'ha'가 나옵니다.
대괄호와 반복 기호
[ ]는 "이 중 한 글자"이고, 뒤에 붙는 * + ? { }는 "바로 앞 한 덩어리를 몇 번"입니다. .은 줄바꿈만 빼고 아무 글자 하나입니다.
s = 'I have a Dream.'
print(re.findall('[ahm]', s))
# ['h', 'a', 'a', 'a', 'm']
# a~m 소문자만 (I, D는 대문자)
print(re.findall('[a-m]', s))
# ['h', 'a', 'e', 'a', 'e', 'a', 'm']
print(re.findall('r..m', s))  # ['ream']

nums = 'I am 10 years old.'
print(re.findall('[0-9]', nums))
# ['1', '0']
# +를 붙이면 이어진 숫자를 통째로
print(re.findall(r'\d+', nums))  # ['10']
o의 개수만 다른 단어들로 반복 기호를 비교하면 차이가 바로 보입니다.
s = 'cl col Coor coool pool cooool'
print(re.findall('co*l', s))  # 0번 이상
# ['cl', 'col', 'coool', 'cooool']
print(re.findall('co+l', s))  # 1번 이상
# ['col', 'coool', 'cooool']
print(re.findall('co?l', s))  # 0 또는 1번
# ['cl', 'col']
print(re.findall('co{3}l', s))  # 딱 3번
# ['coool']
헷갈렸던 건 ^입니다. [^ave]처럼 대괄호 바로 뒤에 오면 "이 글자들 빼고"이고, 대괄호 밖 패턴 맨 앞에 오면 "문자열 시작"입니다. 기호 전체 표와 결과는 파이썬 치트시트에 정리했습니다.
☁️ 워드클라우드: 많이 쓴 단어를 크게
워드클라우드는 글에서 많이 나온 단어일수록 크게 그린 그림입니다. 뉴스 기사의 핵심 키워드나 리뷰에서 자주 나온 말을 한눈에 볼 때 씁니다. 순서는 txt 읽기, 단어 쪼개서 세기, 불용어 빼기, WordCloud로 그리기입니다.
단어 세기: 딕셔너리와 Counter
피천득의 수필 「인연」을 txt로 저장해 두고 읽었습니다.
# UnicodeDecodeError가 나면 encoding='cp949'
with open('인연.txt', 'r',
          encoding='utf-8') as f:
    text = f.read()

wordlist = []
for x in text.split():  # 공백·줄바꿈 기준
    # 마침표 붙은 단어, 한 글자는 버림
    if '.' not in x and len(x) > 1:
        wordlist.append(x)
print(wordlist[:5])
# ['지난', '사월', '춘천에', '가려고', '하다가']
단어별 개수는 딕셔너리로 셉니다. C였다면 단어 배열과 개수 배열을 따로 두고 strcmp로 하나씩 찾아가며 셌을 일입니다.
word_count = {}
for w in set(wordlist):  # 중복 뺀 단어마다
    word_count[w] = wordlist.count(w)
collections.Counter를 쓰면 이 두 줄이 한 줄이 되고, 많이 나온 순서도 바로 뽑힙니다. 불용어는 분석에 도움이 안 되는 흔한 말입니다.
from collections import Counter

stop_words = ['그리고', '있는', '이런', '그는',
              '아니', '같은', '내가', '나는',
              '하고', '나를']

word_count = Counter(wordlist)
for w in stop_words:
    word_count.pop(w, None)  # 없으면 넘어감
print(word_count.most_common(3))
# [('아사꼬는', 8), ('아사꼬의', 5),
#  ('미우라', 4)]
한계도 바로 보입니다. split()은 띄어쓰기만 보니까 아사꼬는과 아사꼬의가 다른 단어로 세어집니다. 마침표 조건은 마침표만 떼는 게 아니라 말았다. 같은 단어를 통째로 버립니다.
한글은 폰트 경로부터
import matplotlib.pyplot as plt
from wordcloud import WordCloud

# 맥 기본 한글 폰트
font = ('/System/Library/Fonts/'
        'AppleSDGothicNeo.ttc')

wc = WordCloud(font_path=font,
               width=2000, height=1000,
               max_font_size=100,
               background_color='white')
wc.generate_from_frequencies(word_count)

plt.figure(figsize=(12, 6))
plt.imshow(wc)
plt.axis('off')  # 축 눈금 없애기
plt.show()
font_path를 빼면 기본 영문 폰트로 그려서 한글이 전부 네모(□)로 나옵니다. font_path=''처럼 비워 두면 OSError: cannot open resource가 납니다.
내 공부 노트북을 txt 하나로
책 대신 지금까지 쓴 제 공부 노트북을 넣어 보기로 했습니다. "파이썬을 배우면서 제일 많이 본 단어"를 그려 보는 겁니다. .ipynb는 사실 JSON 파일이라 json.load로 열면 nb['cells'] 안에 셀마다 source(줄 리스트)가 들어 있습니다.
import glob, json, os

texts = []
paths = sorted(glob.glob('notes/*.ipynb'))
for path in paths:
    name = os.path.basename(path)
    # 이 코드가 든 노트북 자신은 빼기
    if name.startswith('13_'):
        continue
    with open(path, encoding='utf-8') as f:
        nb = json.load(f)
    for cell in nb['cells']:
        # 줄 리스트 → 문자열 하나
        src = ''.join(cell['source'])
        texts.append(src)

with open('notes.txt', 'w',
          encoding='utf-8') as f:
    f.write('\n'.join(texts))
print(len(texts))  # 셀 1,200개 남짓
처음에는 '13_워드클라우드' in path처럼 한글 이름으로 걸렀는데 한 번도 걸리지 않았습니다. 맥에서는 한글 파일 이름이 자모로 풀린 형태(NFD)로 저장된 경우가 있습니다. 화면에는 똑같이 보여도 코드에 친 '가'는 한 글자(NFC)이고, 파일 이름 쪽은 초성 ㄱ과 중성 ㅏ 두 글자라 비교가 실패합니다. 제 노트북은 22개 중 14개가 이 상태였고, 아래 그림에는 이 노트북 자신도 들어가 있습니다.
import unicodedata

nfc = '가'
nfd = unicodedata.normalize('NFD', nfc)
print(nfc == nfd)  # False
print(len(nfc), len(nfd))  # 1 2
print(unicodedata.normalize('NFC', nfd)
      == nfc)  # True
그래서 숫자나 영어(13_)로 거르는 쪽이 안전합니다. 한글로 거르고 싶으면 unicodedata.normalize('NFC', path)로 맞춘 다음 비교합니다.
형태소 분석으로 조사 떼기
split()만으로는 리스트를과 리스트의가 다른 단어가 됩니다. 한글은 형태소 분석기 kiwipiepy로 명사(NNG 일반명사, NNP 고유명사)만 남기면 조사가 저절로 떨어집니다. 다만 용어가 잘게 쪼개질 수 있어서 사용자 사전에 등록해 둡니다.
from kiwipiepy import Kiwi

kiwi = Kiwi()
text = '예외처리와 정규표현식'
print([t.form for t in kiwi.tokenize(text)])
# ['예외', '처리', '와', '정규', '표현', '식']

# 사용자 사전: 용어가 쪼개지지 않게
kiwi.add_user_word('예외처리', 'NNP')
kiwi.add_user_word('정규표현식', 'NNP')
print([(t.form, t.tag)
       for t in kiwi.tokenize(text)])
# [('예외처리', 'NNP'), ('와', 'JC'),
#  ('정규표현식', 'NNP')]
노트북에는 코드도 섞여 있어서 사전을 세 개 만들었습니다.
| 사전 | 하는 일 |
|---|---|
| 사용자 사전 | 매개변수 같은 용어 15개를 한 단어로 |
| 파이썬 단어 사전 | 영어는 여기 있는 이름만 남김 |
| 불용어 사전 | 사용·확인·코드 같은 흔한 말, 예제 속 사람 이름 106개를 뺌 |
파이썬 단어 사전은 예약어, 내장 이름, 자료형 메서드 이름을 합친 집합입니다. 변수 이름 a, x 같은 건 여기 없어서 자연스럽게 탈락합니다. 전처리에는 앞에서 배운 정규식을 그대로 썼습니다.
import builtins, keyword, re

# 예약어 + 내장 이름(함수·예외·상수)
py_words = (set(keyword.kwlist)
            | set(dir(builtins)))
for t in [str, list, tuple, dict, set]:
    py_words |= set(dir(t))  # 메서드 이름
print(len(py_words))  # 315

# 링크 지우기
text = re.sub(r'https?://\S+', ' ', text)
# 한글·영어·_ 말고는 전부 공백으로
text = re.sub(r'[^가-힣A-Za-z_\s]',
              ' ', text)
[^가-힣A-Za-z_\s]는 대괄호 맨 앞의 ^ 때문에 "한글, 영어, 밑줄, 공백 빼고 전부"라는 뜻입니다. 이렇게 모으니 명사 6,695개와 파이썬 단어 2,112개가 나왔습니다. 불용어를 빼면 서로 다른 단어가 739개였고, 그중 많이 나온 140개만 썼습니다.
파이썬 로고 모양으로
그림을 숫자 배열로 바꿔 mask=에 넣으면 흰색 칸은 비우고 나머지 모양 안에만 글자를 채웁니다. 흰 배경 파이썬 로고를 틀로 썼습니다.
import numpy as np
from PIL import Image

# 그림 → 숫자 배열 (세로, 가로, 3)
img = Image.open('python_logo.png')
logo = np.array(img.convert('RGB'))
print(logo.shape)  # (2000, 2000, 3)

wc = WordCloud(font_path=font,
               mask=logo,  # 흰 칸은 비움
               background_color='white',
               max_words=2000,
               max_font_size=220,
               repeat=True,  # 단어 반복해 채움
               random_state=42)  # 같은 그림
wc.generate_from_frequencies(word_count)
wc.to_file('python_wordcloud.png')
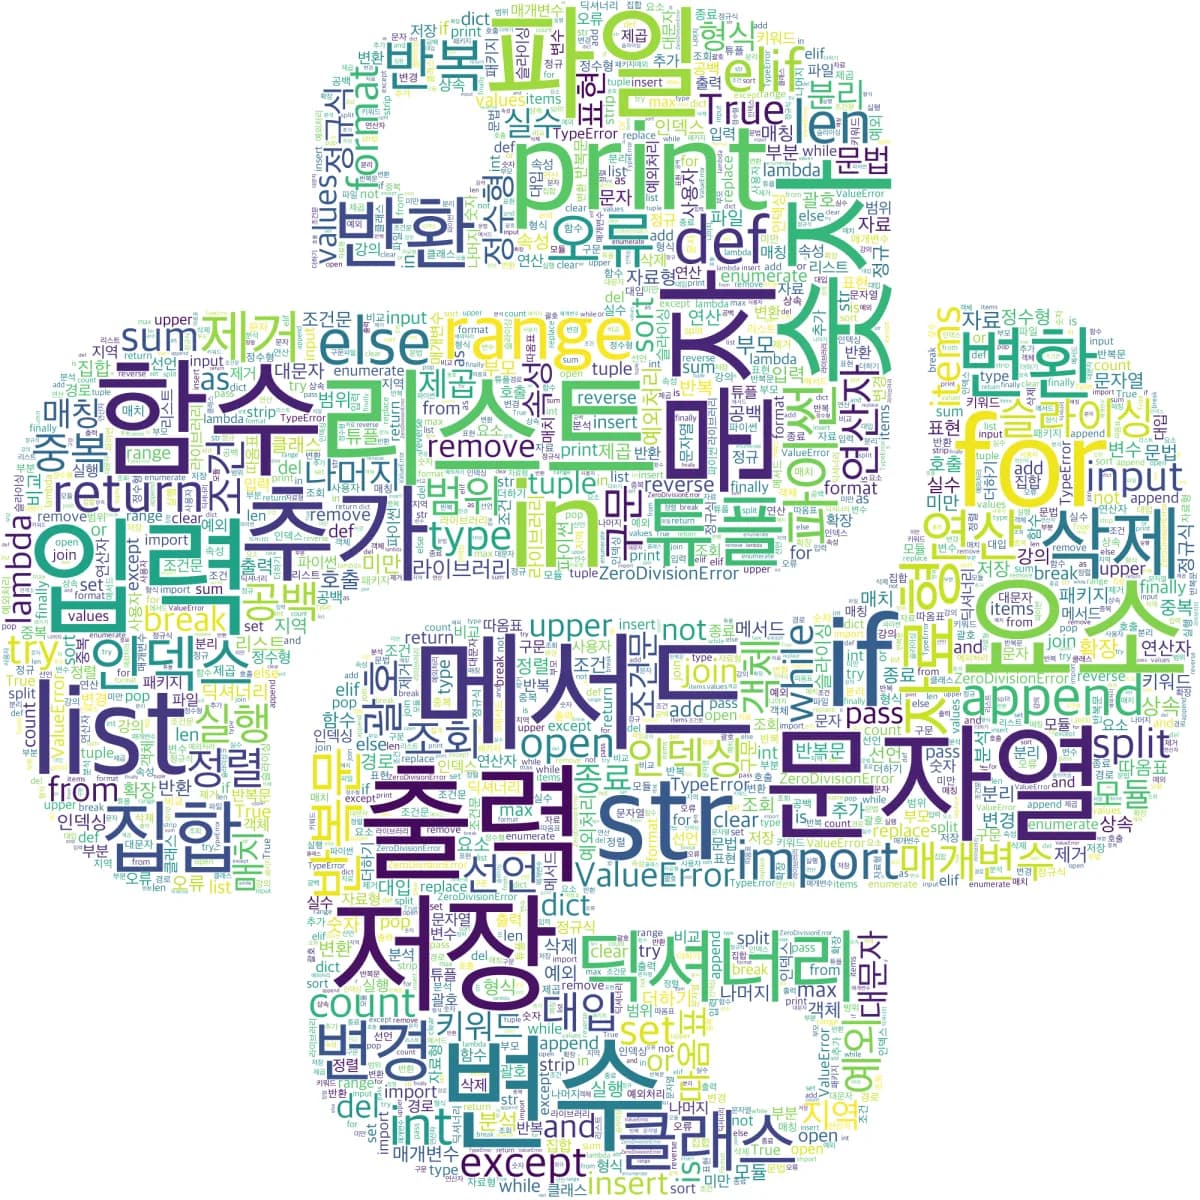
제일 많이 나온 단어는 568번 나온 print였고, 리스트(279)·문자열(198)·함수(173)·출력(169)이 뒤를 이었습니다. 실제로 제일 많이 친 게 print였던 셈입니다.
그런데 그림에서는 print만 유난히 크지 않습니다. repeat=True를 주면 relative_scaling이 자동으로 0이 됩니다. 그러면 횟수 비율은 안 보고 순위만 봐서, 1위부터 16위까지가 전부 최대 크기(220)로 그려졌습니다. 횟수 차이를 크기로 보이게 하려면 relative_scaling=0.5를 직접 주면 됩니다.
random_state=42를 줬기 때문에 몇 번을 다시 돌려도 같은 그림이 나옵니다.
🧱 클래스: 설계도와 객체
클래스는 데이터(속성)와 그 데이터를 다루는 함수(메서드)를 한 묶음으로 정의한 설계도입니다. 객체는 그 설계도로 찍어 낸 실물입니다. C로 치면 struct에 함수까지 붙인 모양입니다.
함수만으로 캐릭터 두 명의 체력을 관리하면 체력 변수를 캐릭터마다 따로 두고, 함수에 넘기고, 돌려받아 다시 저장해야 합니다.
hero_hp = 100
wizard_hp = 100

def take_damage(hp, damage):
    return hp - damage  # 돌려받아야 반영

hero_hp = take_damage(hero_hp, 30)
wizard_hp = take_damage(wizard_hp, 20)
print(hero_hp, wizard_hp)  # 70 80
클래스로 묶으면 객체가 자기 데이터를 들고 다닙니다.
class Character:
    def __init__(self, name):
        self.name = name  # 이 객체의 이름
        self.hp = 100  # 이 객체의 체력

    def take_damage(self, damage):
        self.hp -= damage  # return 필요 없음
        print(f'{self.name}: {damage} 피해')

hero = Character('용사')
wizard = Character('마법사')
hero.take_damage(30)  # 용사: 30 피해
wizard.take_damage(20)  # 마법사: 20 피해
print(hero.hp, wizard.hp)  # 70 80
예제 원본은 f'{name}이 ...'이라서 "용사이", "마법사이"로 찍혔습니다. 이름의 받침에 따라 조사가 달라지니 아예 빼고 썼습니다.
계산기 두 대: global과 클래스
global result로 만든 계산기는 한 대일 때는 간단합니다. 두 대가 필요하면 result1, result2 변수와 내용이 똑같은 add1, add2 함수를 또 만들어야 합니다. 클래스는 Calculator()를 한 번 더 부르면 끝입니다.
class Calculator:
    def __init__(self):
        self.result = 0  # 계산기마다 따로

    def add(self, num):
        self.result += num
        return self.result

cal1 = Calculator()
cal2 = Calculator()
print(cal1.add(2))  # 2
print(cal1.add(5))  # 7
print(cal2.add(15))  # 15 (cal1과 따로)
self는 점 앞의 객체
cal1.add(5)는 사실 Calculator.add(cal1, 5)입니다. 점 앞의 객체가 self 자리에 자동으로 들어갑니다. C에서 void add(Calc *self, int num)처럼 구조체 포인터를 첫 인자로 넘기던 일을 파이썬이 대신 해 주는 셈입니다.
# 위 코드에 이어서 (cal1.result는 7)
print(Calculator.add(cal1, 3))  # 10
메서드 안에서 self.name = ...으로 속성을 새로 만들 수도 있습니다. 대신 그 메서드를 부르지 않은 객체에는 속성이 아예 없습니다.
class Userdata:
    def set_name(self, data):
        self.name = data

user1 = Userdata()
user1.set_name('영철')  # self ← user1
print(user1.name)  # 영철

user2 = Userdata()
# 의도한 오류: set_name을 안 불러서
# AttributeError: 'Userdata' object
#  has no attribute 'name'
print(user2.name)
init: 만들 때 자동으로
그래서 초기값은 객체를 만들 때 자동으로 불리는 __init__(생성자)에서 채웁니다. 엄밀히는 객체가 만들어진 직후에 불려서 값을 채우는 초기화 메서드입니다. self.name은 객체에 저장돼서 객체가 있는 동안 남고, 그냥 name은 넘어온 매개변수라 __init__이 끝나면 사라집니다.
파이썬에는 같은 이름 함수를 여러 개 두는 오버로딩이 없습니다. __init__을 두 번 정의하면 마지막 것만 남습니다. 인자 없이도, 인자를 넣어서도 만들고 싶으면 기본값 인자로 하나로 합칩니다.
class UserData:
    def __init__(self, name='미지정',
                 email='unk@naver.com'):
        self.name = name
        self.email = email

    def get_info(self):
        print(self.name, self.email)

UserData().get_info()
# 미지정 unk@naver.com
UserData('영호', 'a@b.com').get_info()
# 영호 a@b.com
클래스 변수와 객체 변수
클래스 바로 아래 만든 변수는 모든 객체가 공유하고, self.변수는 객체마다 따로입니다.
class School:
    # 클래스 변수: 모든 객체가 공유
    school_name = '파이썬 고등학교'

    def __init__(self, student_name):
        # 객체 변수: 객체마다 따로
        self.student_name = student_name

s1 = School('아아아')
s2 = School('고고고')
print(s1.school_name)  # 파이썬 고등학교

# 클래스로 바꾸면 전원 바뀜
School.school_name = '자바 고등학교'
print(s1.school_name, s2.school_name)
# 자바 고등학교 자바 고등학교

# 객체로 대입하면 그 객체에만 새 변수
s1.school_name = '나만 전학'
print(s1.school_name, s2.school_name)
# 나만 전학 자바 고등학교
마지막 대입은 클래스 변수를 바꾸는 게 아닙니다. s1에 같은 이름의 객체 변수를 새로 만들어서 클래스 변수를 가리는 것입니다.
연습문제는 학생마다 과목 리스트를 들고 있는 클래스였습니다. 리스트는 꼭 __init__ 안에서 self.subjects = []로 만들어야 학생끼리 섞이지 않습니다.
class Student:
    def __init__(self, name, grade):
        self.name = name
        self.grade = grade
        self.subjects = []  # 학생마다 새 리스트

    def add_subject(self, subject):
        self.subjects.append(subject)

    def display_info(self):
        print(f'{self.name}({self.grade}):',
              ', '.join(self.subjects))

st1 = Student('홍길동', 10)
st2 = Student('김영희', 12)
st1.add_subject('수학')
st1.add_subject('과학')
st2.add_subject('영어')
st1.display_info()  # 홍길동(10): 수학, 과학
st2.display_info()  # 김영희(12): 영어
"과목 리스트 기본값은 빈 리스트"라는 조건을 subjects=[] 기본값 인자로 쓰면 함정에 빠집니다. 기본값 리스트는 함수를 정의할 때 한 번만 만들어져서, 기본값으로 만든 객체는 모두 같은 리스트를 씁니다.
class Bad:
    def __init__(self, subjects=[]):
        self.subjects = subjects

a, b = Bad(), Bad()
a.subjects.append('수학')
print(b.subjects)  # ['수학']
인자로 받고 싶으면 subjects=None으로 두고, 안에서 None이면 새 []를 만듭니다.
상속과 오버라이딩
class 자식(부모):로 쓰면 부모 메서드를 그대로 물려받고, 자기 메서드를 더할 수 있습니다. 물려받는 방향은 부모에서 자식으로만입니다.
class Parents:
    def sing(self):
        print('Old song')

class Child(Parents):  # Parents 상속
    def dance(self):
        print('k-pop dance')

kid = Child()
kid.sing()  # Old song (물려받음)
kid.dance()  # k-pop dance
# 의도한 오류: 부모는 자식 메서드를 못 씀
# AttributeError: 'Parents' object
#  has no attribute 'dance'
Parents().dance()
자식이 부모와 같은 이름의 메서드를 다시 정의하면 자식 것이 이깁니다(오버라이딩). 부모 동작을 버리지 않고 덧붙이고 싶으면 super()로 부모 메서드를 먼저 부릅니다.
class Child2(Parents):
    def sing(self):  # 같은 이름으로 재정의
        super().sing()  # 부모 것 먼저
        print('New song')

Child2().sing()
# Old song
# New song
부모를 둘 이상 둘 수도 있습니다(다중 상속). 같은 이름 메서드가 여러 부모에 있으면 괄호 왼쪽 부모부터 찾고, 찾는 순서는 __mro__로 확인합니다.
class P1:
    def greet(self):
        print('P1')

class P2:
    def greet(self):
        print('P2')

class C(P1, P2):
    pass

C().greet()  # P1 (왼쪽 부모 먼저)
print([k.__name__ for k in C.__mro__])
# ['C', 'P1', 'P2', 'object']
🎲 추가 문제: 주사위 세 개 상금
주사위 세 개의 눈을 입력받아 상금을 출력하는 문제입니다.
| 나온 눈 | 상금 |
|---|---|
| 같은 눈 3개 | 10,000 + 눈 × 1,000 |
| 같은 눈 2개 | 1,000 + 눈 × 100 |
| 모두 다름 | 가장 큰 눈 × 100 |
3 3 6이면 1,300, 2 2 2면 12,000, 6 2 5면 600입니다. 처음 쓴 코드로 세 예시를 넣어 보니 답이 다 맞았습니다.
def dice_value():
    dice = sorted(list(map(
        int, input().split())))
    if(dice[0] == dice[1] == dice[2]):
        return 10000 + dice[0] * 1000

    elif(dice[0] == dice[1]
         or dice[1] == dice[2]):
        return 1000 + dice[1] * 100

    else:(dice[0] != dice[1] != dice[2])
    return max(dice) * 100

dice_value()
정렬부터 하니 비교할 자리가 정해져서 조건이 짧아졌습니다. dice[0] == dice[1] == dice[2]는 파이썬에서 a == b and b == c로 풀립니다. C에서 a == b == c는 (a == b) == c라서, 0이나 1을 c와 비교하는 전혀 다른 식이 됩니다.
우연히 맞았던 else
다시 보니 else: 줄이 이상했습니다. else 뒤에는 조건을 붙일 수 없습니다. else:(식)은 else 블록 안에서 그 식을 계산하고 버리는 한 줄입니다.
그다음 return max(dice) * 100은 if와 같은 칸이라 if 바깥, 그냥 함수 본문입니다. 코드 구조를 직접 찍어 보면 확실합니다.
import ast

# dice.py = 위 코드를 저장한 파일
with open('dice.py', encoding='utf-8') as f:
    fn = ast.parse(f.read()).body[0]
print([type(s).__name__ for s in fn.body])
# ['Assign', 'If', 'Return']
앞의 두 경우는 이미 return으로 빠져나가니 마지막 줄까지 오는 건 모두 다른 경우뿐입니다. 그래서 우연히 맞았습니다. 위쪽 분기 하나라도 return 대신 print로 바꾸면 그 경우도 마지막 return까지 내려와서 엉뚱한 값을 돌려줍니다.
!=를 이어 쓴 것도 함정입니다. a != b != c는 a와 c를 비교하지 않아서 3 != 5 != 3이 True입니다. 이 코드에서는 계산 결과를 버렸으니 영향이 없었습니다.
같은 눈 2개일 때 dice[1]을 쓴 건 맞았습니다. 정렬하면 a ≤ b ≤ c이고, a와 c가 같으면 가운데 b도 같아서 셋 다 같은 경우가 됩니다. 그래서 짝은 (a, b) 아니면 (b, c)이고, 어느 쪽이든 가운데 b가 들어갑니다.
하나 더 있었습니다. 문제는 상금을 "출력"하라는데 코드에 print가 없습니다. 주피터는 셀 마지막 줄의 값을 보여 줘서 숫자가 찍혔을 뿐이고, .py로 돌리면 아무것도 나오지 않습니다.
고친 버전
입력과 계산을 나눠서 함수에 리스트만 넣으면 바로 확인할 수 있게 했습니다. sorted()는 반복 가능한 값이면 다 받으니 list()로 한 번 더 감쌀 필요가 없고, 언패킹으로 이름을 붙이면 dice[0]보다 읽기 쉽습니다.
def dice_prize(dice):
    a, b, c = sorted(dice)  # a <= b <= c
    if a == b == c:
        return 10000 + a * 1000
    elif a == b or b == c:
        # 짝에는 항상 가운데 b가 들어감
        return 1000 + b * 100
    else:
        return c * 100  # c가 가장 큰 눈

print(dice_prize([3, 3, 6]))  # 1300
print(dice_prize([2, 2, 2]))  # 12000
print(dice_prize([6, 2, 5]))  # 600
실제로 입력을 받을 때는 print(dice_prize(map(int, input().split()))) 한 줄이면 됩니다.
오늘의 한 줄
정규 표현식은
re.sub(r'패턴', 바꿀 값, 문자열)로 찾아 바꾸고,( )로 묶은 부분은\g<1>로 다시 씁니다. 워드클라우드는 단어를 Counter로 세어WordCloud에 넘기면 되고, 한글은font_path가 필수입니다. 클래스는 설계도, 객체는 실물이고, self는 점 앞의 그 객체입니다. 초기값은__init__에서 채우고, 객체마다 따로 쓸 리스트는self.변수 = []로 만듭니다.
워드클라우드는 지금까지 배운 게 다 모인 실습이었습니다. 파일을 읽고, 딕셔너리로 세고, 정규식으로 다듬었습니다. 직접 해 보려면 자주 읽는 글 하나를 txt로 저장하고 Counter로 세는 데까지만 먼저 돌려 보면 됩니다. 그것만으로도 그 글이 무엇을 많이 말하는지 보입니다.